问题:在文本中找模式串
给主串 S 和模式串 P,找 P 在 S 中的位置。暴力做法是每个起点都从头比:失配时主串指针回溯、模式串指针归零,最坏 O(n·m)。
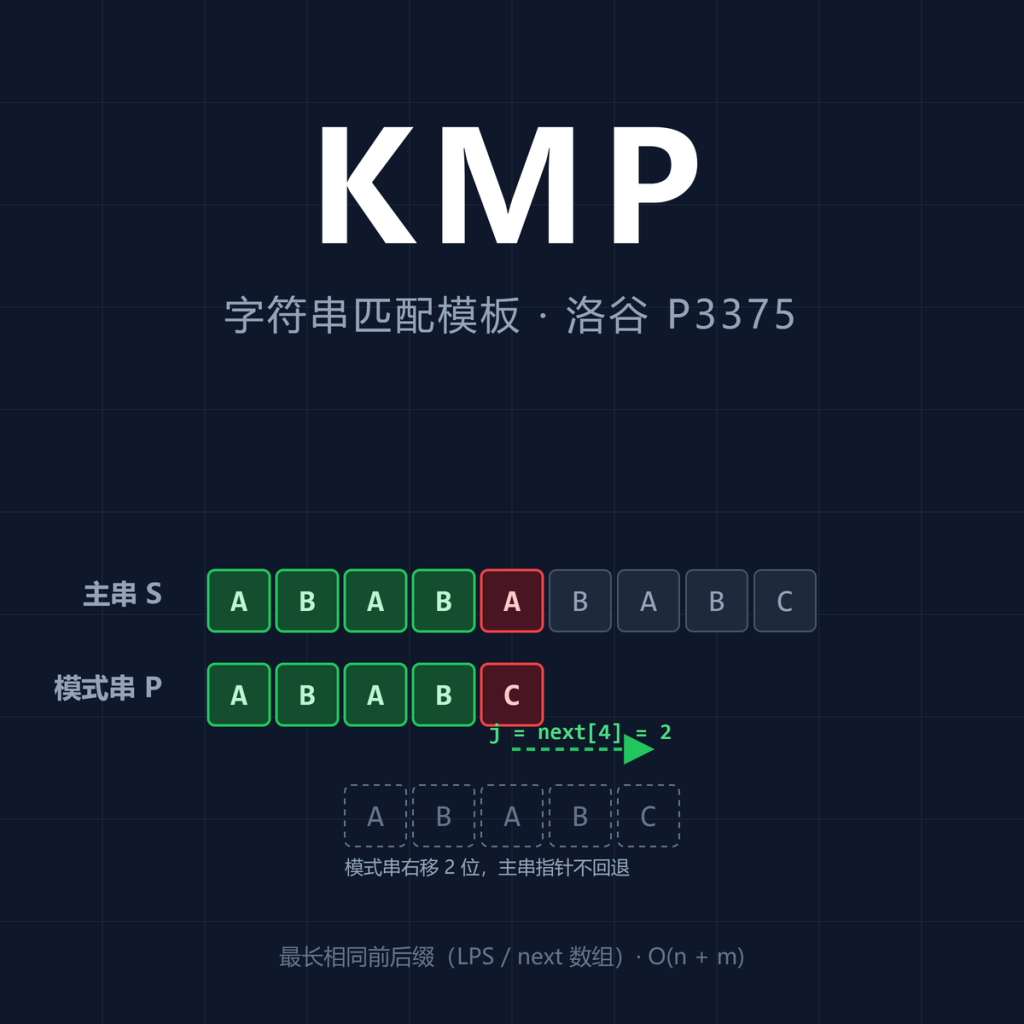
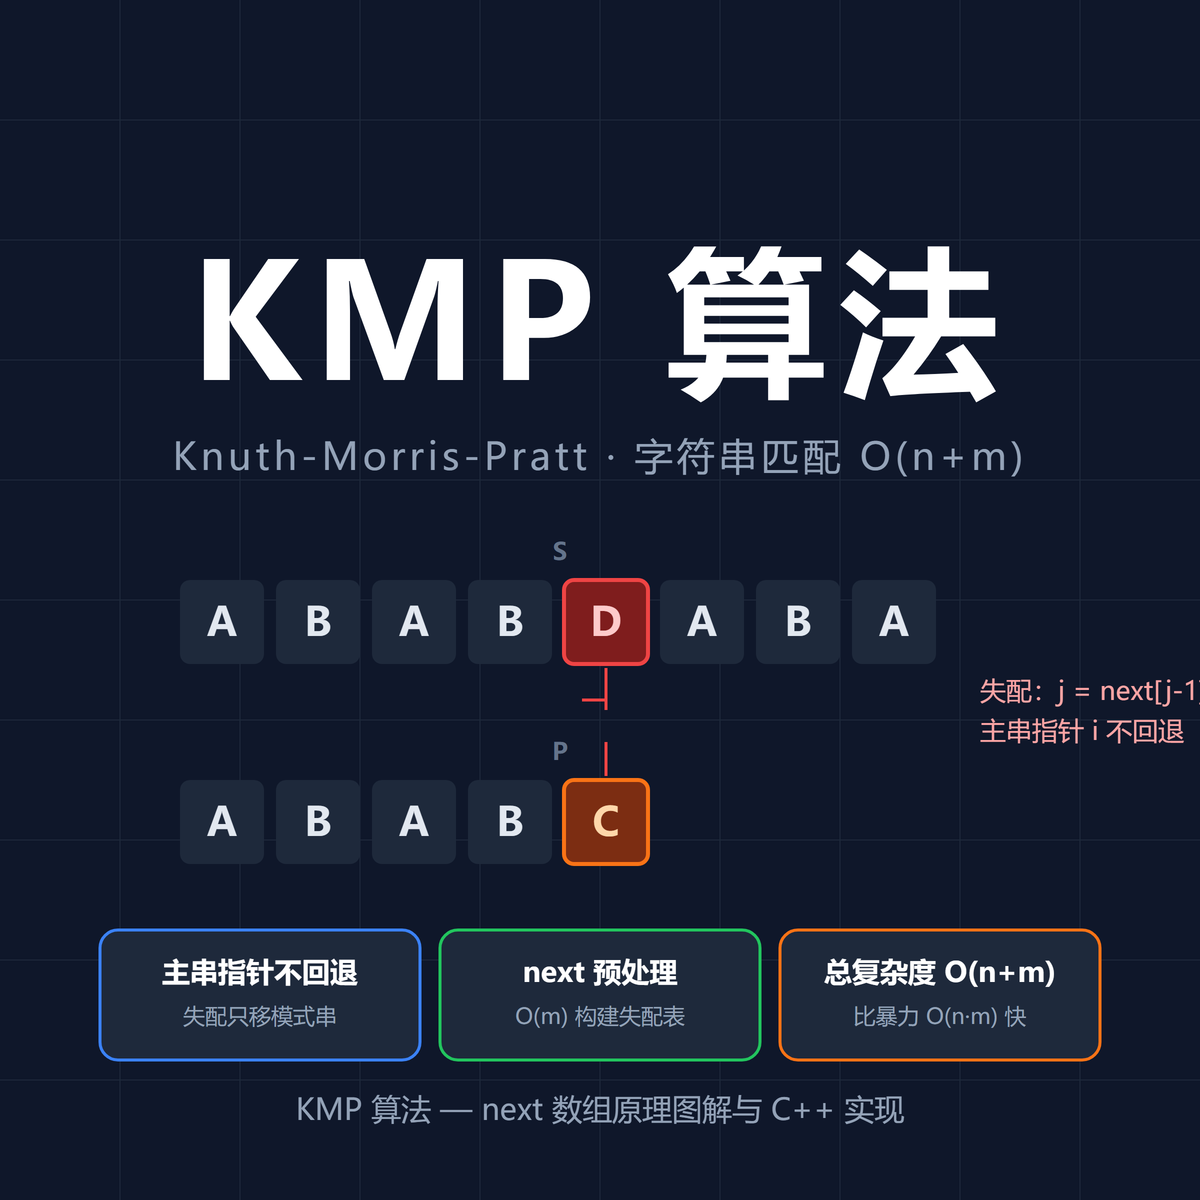
KMP 的核心是:主串指针 i 永不回溯,失配时只移动模式串指针 j,移动多少由预处理好的 next 数组决定。已匹配的部分不会白比——它能作为前缀继续匹配的长度,恰好是已匹配后缀里最长的”相同前后缀”。
next 数组:记录失配后跳哪
定义 next[i] 为 P[0..i](含 P[i])的最长相同前后缀长度,前后缀都不能取整个串。失配时 j 回退到 next[j-1]:j-1 是已匹配部分的下标,它的 border 长度就是可以安全继续匹配的位置。
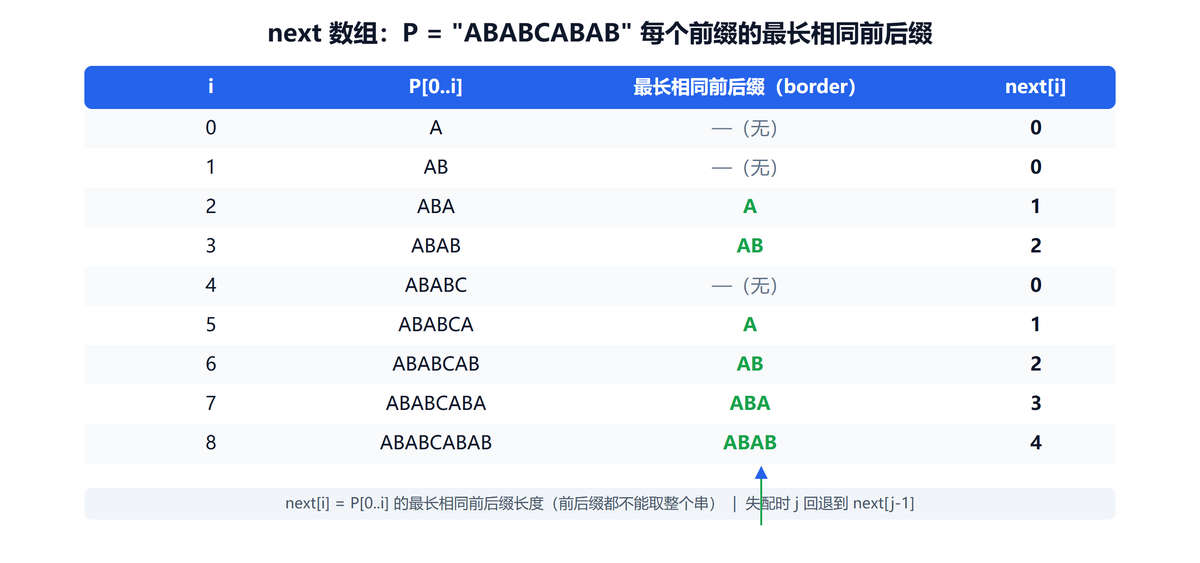
以 P = "ABABCABAB" 为例,逐位算出的 border 见上图,next = [0, 0, 1, 2, 0, 1, 2, 3, 4]。注意 border 只看前缀:P[0..3]=”ABAB” 的 border 是 “AB”(长度 2),所以已匹配 4 个字符后失配,j 跳到 2 而不是清零。
构建 next 数组(O(m))
vector<int> computeNext(const string& p) {
    int m = p.size();
    vector<int> next(m, 0);
    for (int i = 1, j = 0; i < m; i++) {
        while (j > 0 && p[i] != p[j]) j = next[j - 1];
        if (p[i] == p[j]) j++;
        next[i] = j;
    }
    return next;
}
i 从 1 开始,j 维护”当前最长 border 的已匹配长度”。字符相等 j+1;不等则沿 j = next[j-1] 回退,直到相等或 j 归零。构建和匹配共用同一套回退逻辑,这是最容易写错的地方——回退要用 next 数组,不是直接 j = 0。
匹配过程(O(n))
int kmpSearch(const string& s, const string& p) {
    int n = s.size(), m = p.size();
    if (m == 0) return 0;
    vector<int> next = computeNext(p);
    for (int i = 0, j = 0; i < n; i++) {
        while (j > 0 && s[i] != p[j]) j = next[j - 1];
        if (s[i] == p[j]) j++;
        if (j == m) return i - m + 1;   // 找到,返回起始下标
    }
    return -1;
}
主串指针 i 只前进,失配时 j 按 next 跳转。要接着找下一个匹配,把命中处理改成 j = next[m-1] 即可,重叠匹配也能找全。
示例走查
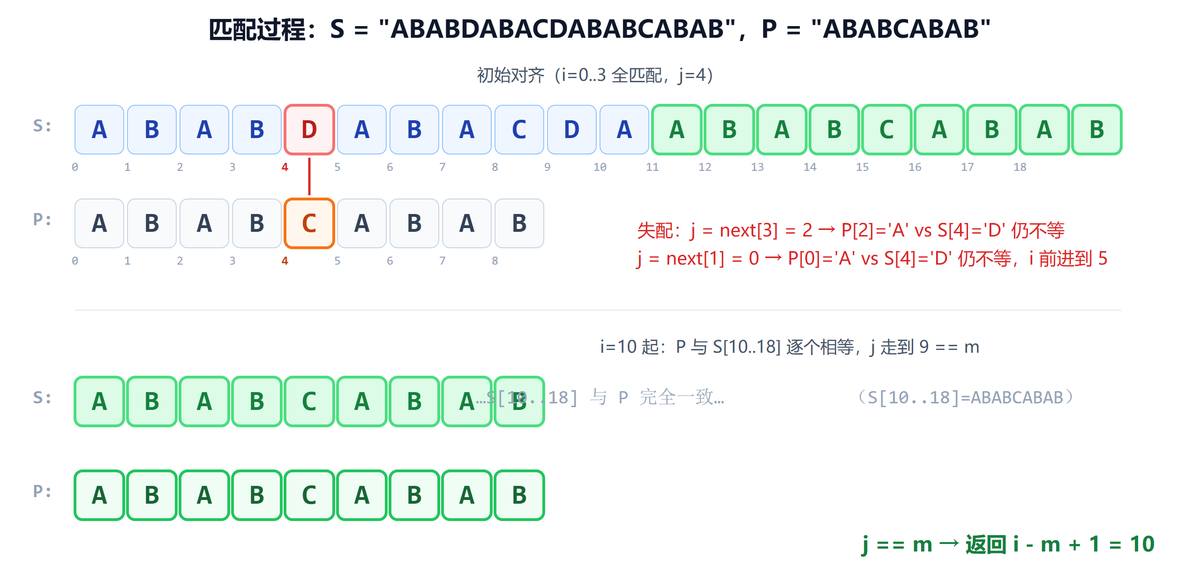
主串 S = "ABABDABACDABABCABAB",模式串 P = "ABABCABAB":
i=0..3: A B A B 全部匹配,j=4
i=4:   S[4]='D' != P[4]='C',j = next[3] = 2
       S[4]='D' != P[2]='A',j = next[1] = 0
       S[4]='D' != P[0]='A',i 前进(主串指针不回退)
i=5..8: 匹配 ABAB,j=4
i=9:   S[9]='D' != P[4]='C',j = next[3] = 2
       S[9]='D' != P[2]='A',j = next[1] = 0
       S[9]='D' != P[0]='A',i 前进
i=10..18: S[10..18]=ABABCABAB 与 P 完全相等,j 走到 9 == m
返回 i - m + 1 = 10
两次失配(i=4 和 i=9)都只靠 next 平移 P,S 的每个字符只被读一次,整体线性。
复杂度与总结
- 构建 next:O(m);匹配:O(n);总复杂度 O(n + m),空间 O(m)(next 数组);
- 相比暴力 O(n·m),省掉的是主串回溯造成的重复比较;
- next 数组”利用已匹配信息、复用前后缀”的思想,是 AC 自动机失败指针、Z 函数等进阶字符串算法的基础。