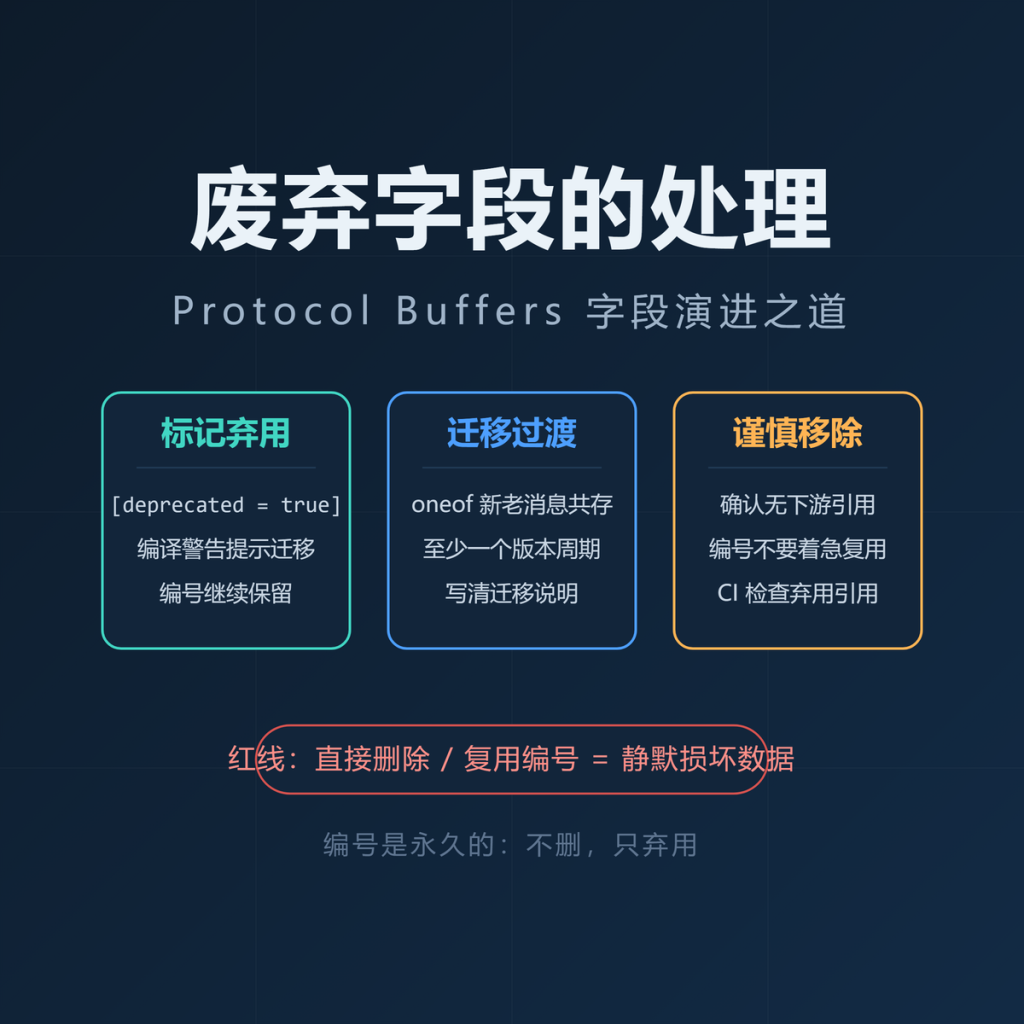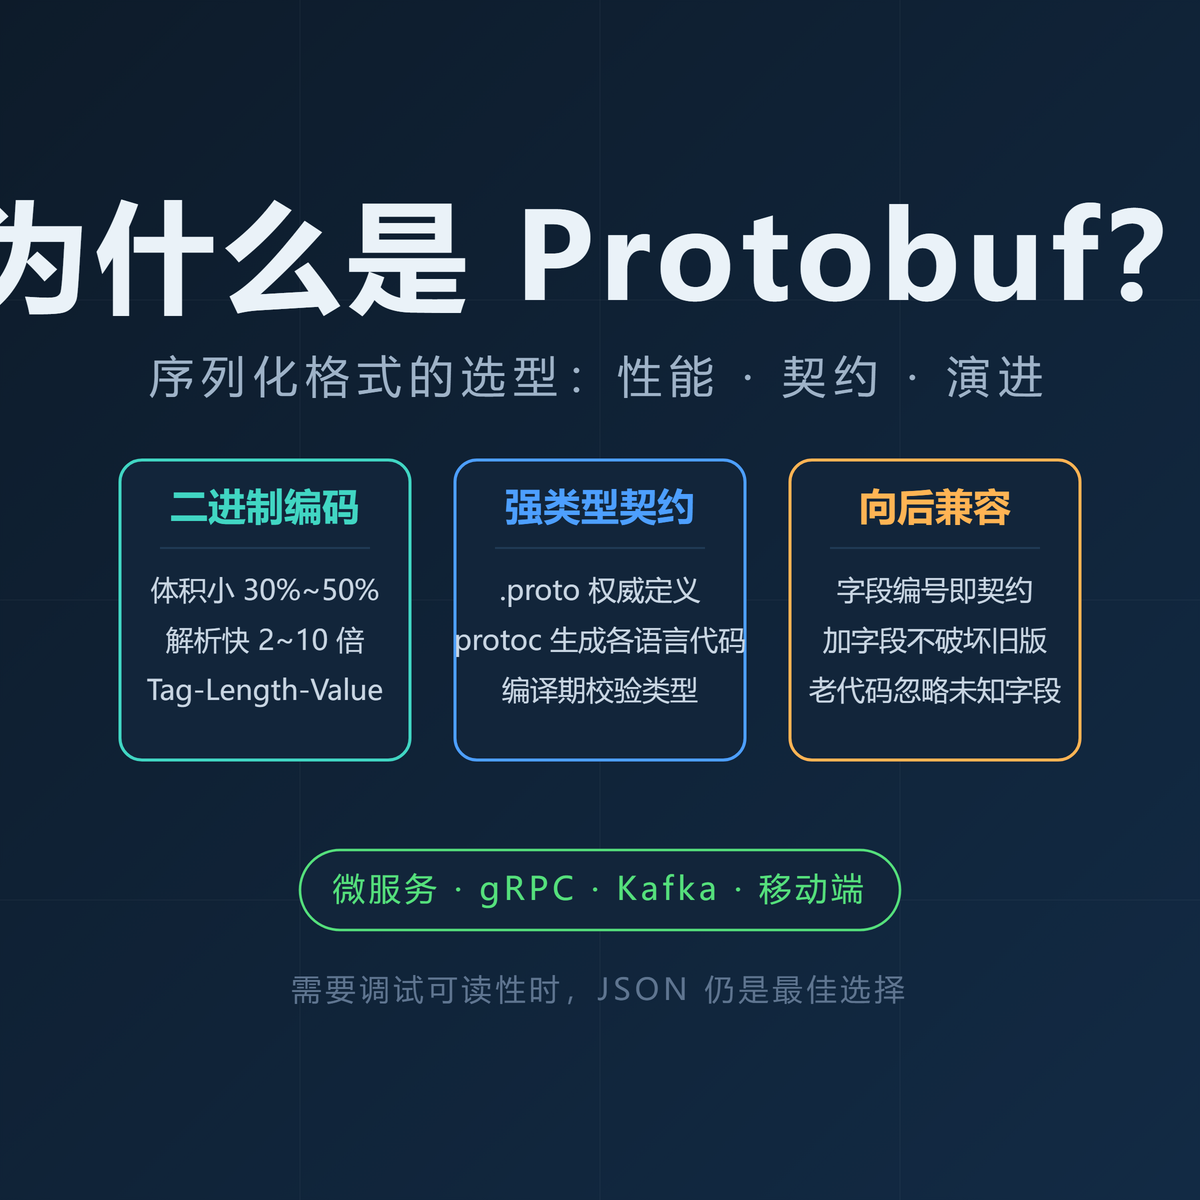
选序列化格式,本质是权衡四个维度:性能体积、跨语言、契约强度、演进能力。Protocol Buffers(protobuf)在这四点上没有明显短板,所以成了微服务通信的事实标准。
1. 高性能与紧凑编码
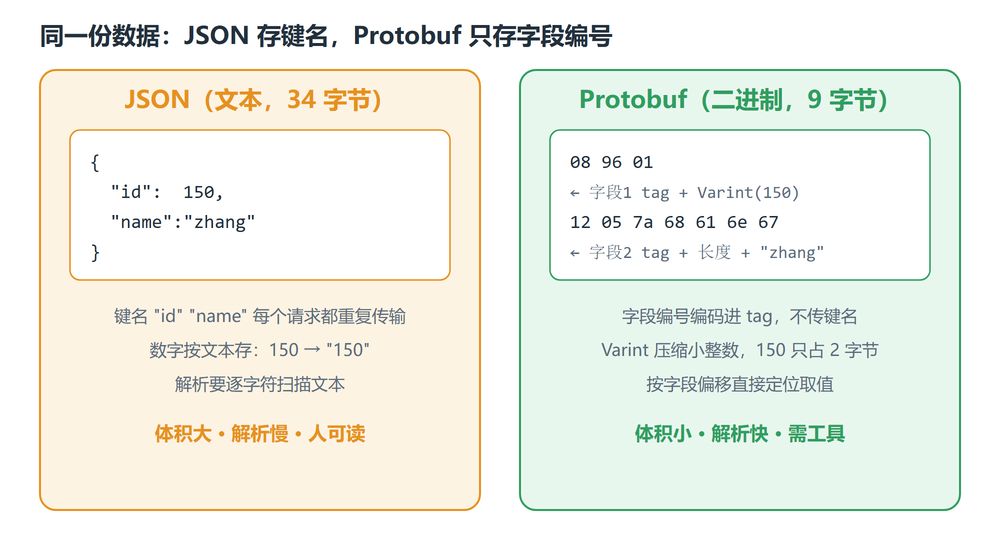
protobuf 是二进制编码,比 JSON/XML 这类文本格式体积通常小 30%–50%,序列化/反序列化快 2–10 倍。体积优势来自 Tag-Length-Value 结构:按字段编号 + 变长整数(Varint)存储,不传键名字符串。JSON 每个字段都要重复传 “id”、”name” 这样的键名;protobuf 只传一个字段编号。
2. 跨语言与代码生成
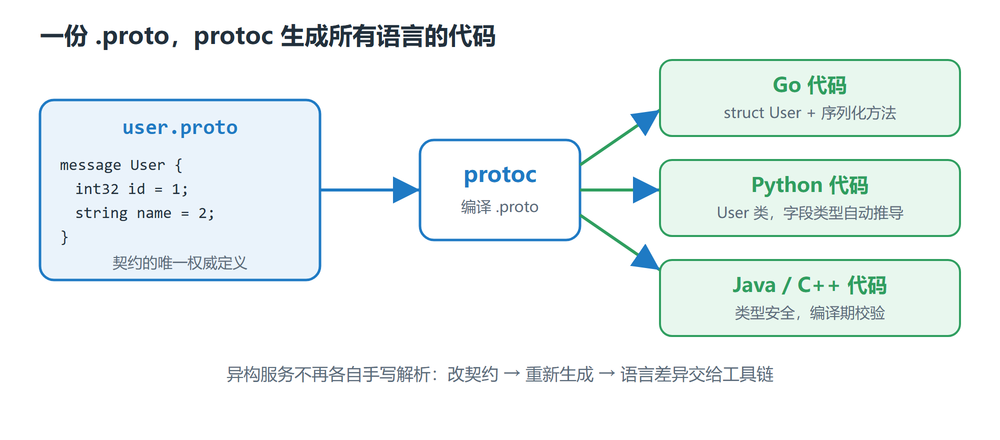
官方支持 C++、Java、Python、Go 等主流语言,社区支持 Rust、Swift 等。一份 .proto 定义,protoc 自动生成各语言的结构体/类——异构系统间通信不用手写解析代码,减少出错。
3. 强类型接口契约
.proto是数据结构的权威定义,字段类型显式声明(int32/string/…),编译期即校验;- 版本兼容:字段编号 + optional/repeated 规则保证向后/向前兼容,老代码忽略未知字段,新代码能读旧数据。
4. 可扩展性
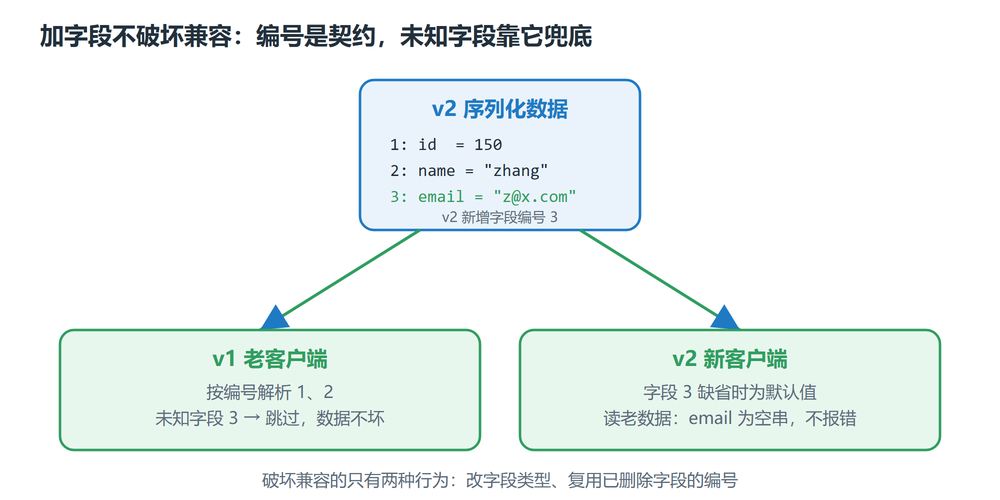
- 新增字段不破坏旧版解析(旧客户端自动忽略);
- 支持嵌套消息、枚举、oneof 等建模复杂结构。
5. RPC 生态
- protobuf 是 gRPC 的默认数据格式,两者深度集成;
- 支持流式请求/响应(gRPC Stream),是微服务通信的事实标准。
与其他协议对比
| 特性 | protobuf | JSON | XML | Thrift/Avro |
|---|---|---|---|---|
| 编码效率 | 高(二进制) | 低(文本) | 最低 | 高 |
| 解析速度 | 快 | 慢 | 最慢 | 快 |
| 跨语言 | 优秀 | 优秀 | 优秀 | 优秀 |
| 强类型 Schema | 必须 | 可选 | 可选(XSD) | 必须 |
| 人类可读 | 差(需工具) | 好 | 好 | 差 |
适用场景
- 微服务通信:gRPC 服务间数据传输;
- 存储序列化:Kafka 消息、数据库二进制列;
- 移动端:省流量省电量;
- 游戏开发:高频网络同步需要低延迟编码。
注意事项
- 调试困难:二进制不可直接阅读,需要工具(
protoc --decode_raw); - 不适合人类可读场景:REST API、需要 curl 调试的接口别用它;
- Schema 管理成本:要维护 .proto 的版本、依赖和代码生成流程(buf 工具链可以简化);
- 体积优势有边界:数据小且字段名短时,JSON 压缩后差距不大;大量重复结构时才显著。