设计背景与意图
游戏数据层的常规做法是「Redis 缓存 + MySQL/Mongo 持久化」:缓存扛读,持久化库保底。代价是同一份数据存在两个地方,业务层得自己维护一致性——先写缓存还是先写库、缓存什么时候失效、崩溃后怎么回源。这套代码不属于任何业务规则(双写、失效、回源是通用问题),却没有标准组件,每个项目都得重写一遍;热更、并发刷数据时,脏数据和并发覆盖也多半出在这里。
github.com/beijian128/protoc-gen-redis 的设计意图,是把这层负担整个消掉:数据只存一份,把 Redis 当数据库用。结构用 protobuf 定义,一个 message 对应一个 Redis Hash,字段对应 Hash field,业务层读写就是几条 Redis 命令。内存 Redis 贵不是问题——生产环境可以换兼容 Redis 协议、支持磁盘持久化的引擎(比如腾讯 Tendis),命令语法不变,应用层零改动(兼容性后面单独说)。
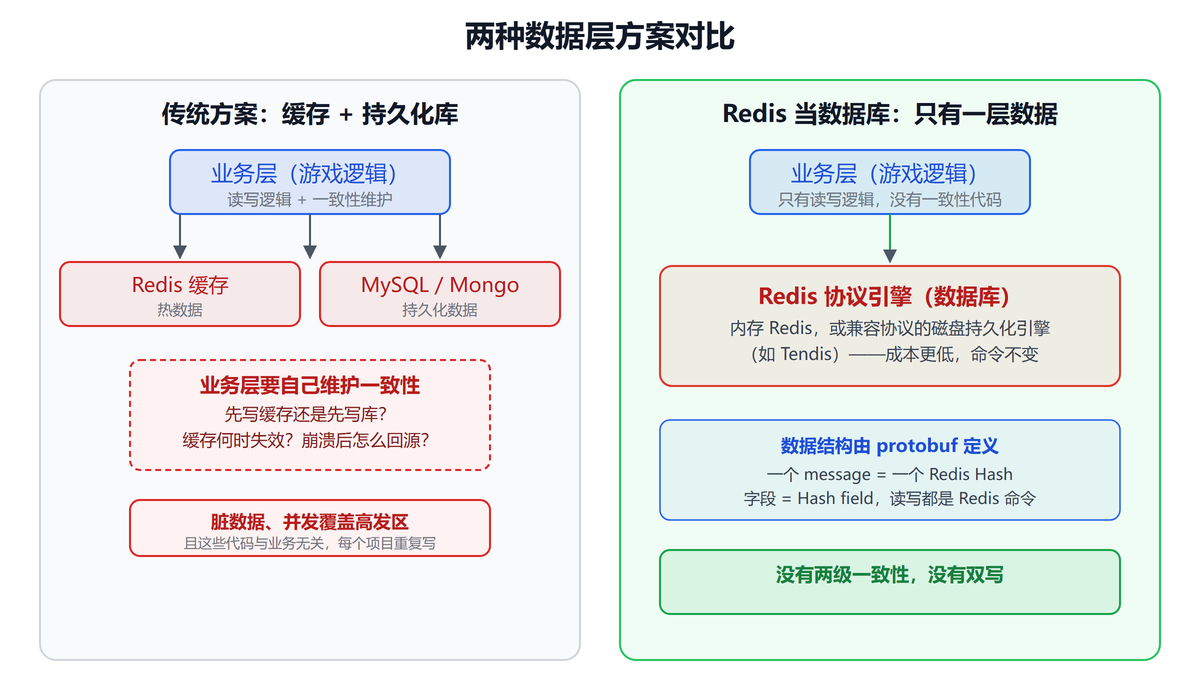
把 Redis 当数据库后,剩下一件重复劳动:每个 message 都要手写 Hash 存取代码——标量字段直存、非标量字段 protobuf 序列化、key 拼接,字段一多就是几百行模板,容易出错也难维护。protoc-gen-redis 就是为消灭这份样板代码写的:输入 .proto,输出完整的 Redis Hash 存取代码,形成「proto 定义结构 → 生成器出代码 → 业务直接调用」的固定流程。本文讲它的存储布局、生成的 API,以及序列化为什么走 protobuf wire format。
存储布局
| 数据类型 | Hash field 名 | Value |
|---|---|---|
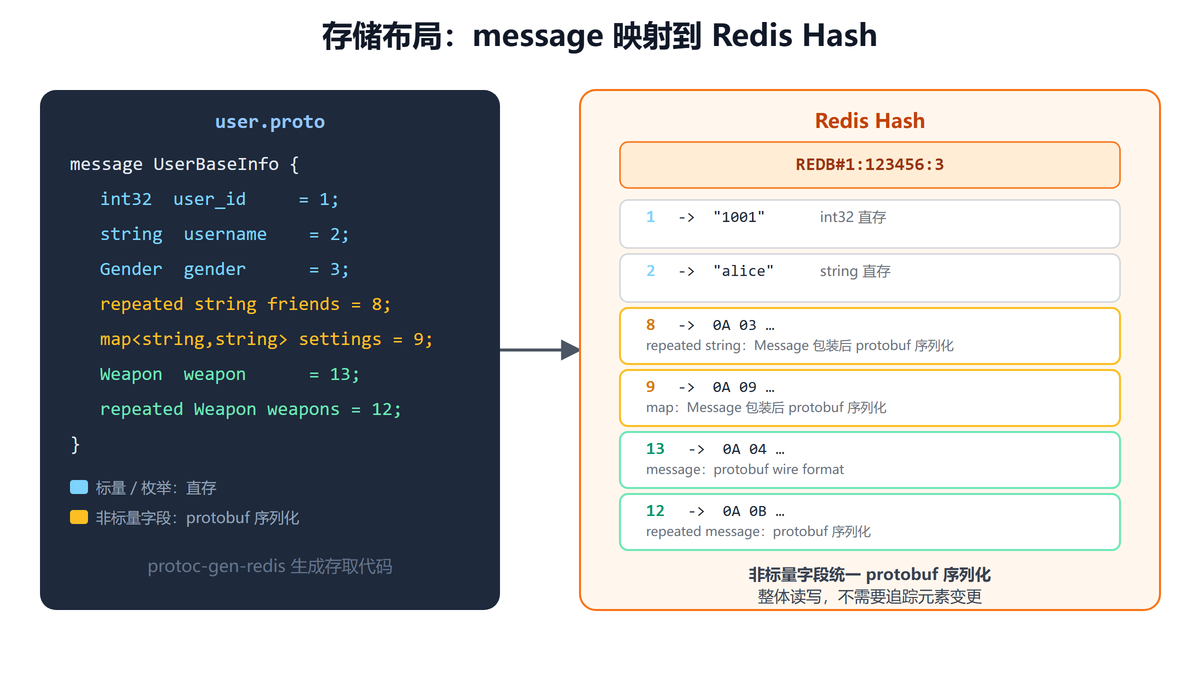
| 标量 / 枚举 / string / bytes | proto tag(如 1、3) | 十进制字符串 / 原样 |
| 嵌套 message / map / repeated(集合字段用 Message 包装后) | proto tag(如 8、13) | protobuf wire format 字节 |
集合字段(map/repeated)不拆成多个 Hash field,而是生成代码里隐式用 Message 包装后整段 protobuf 序列化,存到一个 Hash field。业务层整体读写,不需要追踪”哪些元素变了”。
Hash key 默认形如 REDB#<维度1>:<维度2>:<维度3>,维度数量和含义由 key_format 决定,插件只负责按序填占位符。游戏里最常见的划分:系统 ID 区分业务(家园系统=1、好友系统=2)、玩家 UID 锁用户、赛季 ID 隔离轮换数据——换赛季直接换 key,老数据不掺和,不需要的维度填 0。格式可用 --redis_opt=key_format=... 定制。
生成的 API
生成的文件自包含:message 结构体、枚举、字段常量、存取方法全部重新声明,不依赖 protoc-gen-go 的输出——与 .pb.go 同包会重复定义,输出到独立目录即可直接用。输出文件名是 <proto名>.redis.go,枚举一并生成(命名与 protoc-gen-go 一致),支持跨 proto 文件、跨 Go 包引用。每个 message 生成一组方法:
GetFields/SetFields:按字段整体读写。字段用Field<Message>_<字段名>常量标识(值就是 proto tag),只传要操作的字段就是按需读写。集合字段自动整段序列化/反序列化MarshalRedisProto/UnmarshalRedisProto:非标量字段(嵌套 message + 集合字段包装后)按标准 protobuf wire format 编解码,语言无关
代码示例
proto 定义:
syntax = "proto3";
package user;

message UserBaseInfo {
  int32 user_id = 1;
  string username = 2;
  Gender gender = 3;              // 枚举
  repeated string friends = 8;    // 集合:Message 包装后整体 protobuf 序列化
  map<string, string> settings = 9;
  Weapon weapon = 13;             // 嵌套 message:protobuf 序列化
  repeated Weapon weapons = 12;   // 同上
}
Go 侧使用:
u := &cmddb.UserBaseInfo{
    UserId: 1001, Username: "alice",
    Friends:   []string{"bob", "carol"},
    Settings:  map[string]string{"sound": "80"},
    Weapon:    cmddb.Weapon{Name: "sword", Damage: 10},
}
u.SetFields(conn, 1, 123456, 3) // 整体写入(家园系统=1,赛季 3)

got := &cmddb.UserBaseInfo{}
got.GetFields(conn, 1, 123456, 3, cmddb.FieldUserBaseInfo_Username) // 按需读

// 集合字段整体替换
u.Friends = []string{"x", "y"}
u.SetFields(conn, 1, 123456, 3, cmddb.FieldUserBaseInfo_Friends)
序列化为什么用 protobuf wire format
非标量字段(嵌套 message、map、repeated)存进 Redis 的字节都是标准 protobuf 编码,编码遵循 proto3 语义(零值标量不编码、message 恒编码、repeated 逐元素编码),解码时未知字段跳过、兼容 packed repeated。集合字段隐式用 Message 包装后序列化,结构紧凑且可增量扩展。
游戏服务器常见 Go / C++ / Lua 混布,其他语言拿同一份 .proto 就能直接解析这些字节,不需要和 Go 端协商序列化格式——这是把 gob 换成 protobuf 的原因,gob 只有 Go 能读。
Tendis 兼容性
生成代码只依赖纯 Redis 命令(HSET / HMGET / HGET / HDEL / HSCAN),不涉及 Lua 脚本。任何 RESP 兼容引擎都能跑,包括内存 Redis、腾讯 Tendis 存储版 / 混合存储版、开源 Tendisplus。
磁盘引擎上 HSCAN 是全量遍历,GetAll 的性能比内存 Redis 差,Hash 大时要按业务评估。
使用
go build -o protoc-gen-redis.exe .
protoc --plugin=./protoc-gen-redis.exe --redis_out=. --redis_opt=paths=source_relative user.proto
仓库:github.com/beijian128/protoc-gen-redis。配套的单元测试用 golden 文件对比生成结果,集成测试直连 Redis(也可指向 Tendis)。