“附近的人”的需求一句话就能说完:给一个坐标,找出 5 公里内的人,按距离排序。难点在于数据是二维的,而数据库索引是一维的。本文从 geohash 的二分编码讲起,到 Redis GEO 的数据模型和实测数据、三个最容易搞错的点,再到 300 万在线时的分片设计和隐私防护。
为了验证这些结论,我写了一个模拟程序:在北京城区放约 1000 个会走动的虚拟用户,位置实时写进 Redis 8.10.1,网页地图上可以拖动自己的位置、查看附近的人。第二到第五节标”实测”的数字都来自这个程序;第六节是设计推算,估算处都有标注。
配套交互图解:附近的人:geohash 交互图解。可以一刀一刀看坐标怎么切成 52 位、拖动查询圆看 GEOSEARCH 扫了哪些格子、亲手试一次三角定位。建议边读边开着。
一、问题
给我一个坐标,找出 5 公里内的人,按距离排序,取前 10 个。
数据库里一千万行 (id, 昵称, 经度, 纬度)。直觉写法:
SELECT * FROM user
ORDER BY 距离(经度, 纬度, 116.40, 39.92)
LIMIT 10;
一千万行,每次查询算一千万次球面距离。不行。
加索引:
WHERE 经度 BETWEEN 116.35 AND 116.45
  AND 纬度 BETWEEN 39.85 AND 39.95
也不行。B+ 树是一维的:用经度索引只能筛出一个竖条,纬度还得逐行过滤;联合索引 (经度, 纬度) 里纬度只在经度相同的行之间有序,经度一变就用不上了。
核心矛盾:数据是二维的,索引是一维的。
二、核心机制
2.1 把二维压成一维:二分 26 次
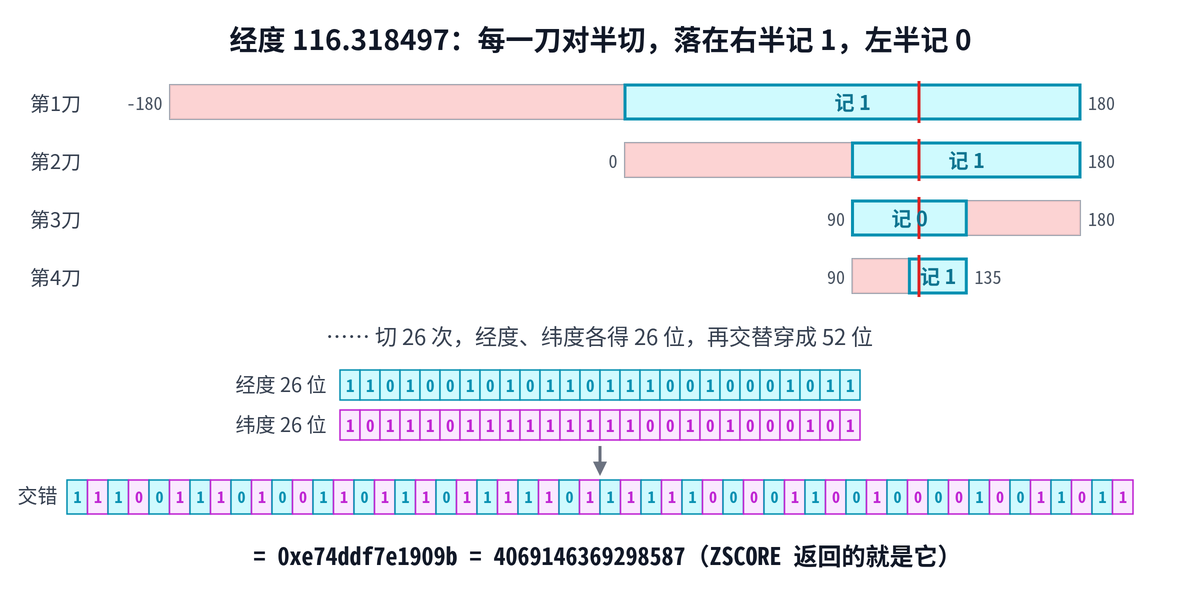
geohash 的做法不是”编码”,是不断对半切。
以经度 116.318497 为例:
| 第几次 | 当前区间 | 中点 | 在左还是右 | 记一位 | 新区间 |
|---|---|---|---|---|---|
| 1 | −180 … 180 | 0 | 右 | 1 | 0 … 180 |
| 2 | 0 … 180 | 90 | 右 | 1 | 90 … 180 |
| 3 | 90 … 180 | 135 | 左 | 0 | 90 … 135 |
| 4 | 90 … 135 | 112.5 | 右 | 1 | 112.5 … 135 |
| 5 | 112.5 … 135 | 123.75 | 左 | 0 | 112.5 … 123.75 |
| 6 | 112.5 … 123.75 | 118.125 | 左 | 0 | 112.5 … 118.125 |
6 次之后区间从 360° 缩到 5.6°。切到 26 次,区间宽 360 / 2²⁶ ≈ 0.0000054°,在赤道上约 0.6 米,在北京(纬度 40° 左右)约 0.46 米。
纬度用同样的方法切,只是起始区间是 ±85.05112878°,不是 ±90°。这是 Web 墨卡托投影能表示的纬度范围,Redis 沿用了它,所以两极附近的点存不进去。
经度  11010010101101110010001011   (26 位)
纬度  10111011111111100101000101   (26 位)
把两组位交替穿起来(经一位、纬一位):
52 位  0xe74ddf7e1909b
十进制 4069146369298587        ← 这就是 ZSCORE 返回的那个数
解码时取最后那个小格子的中心:116.31849735975266, 39.86335055842804。和原始经度 116.318497 只差 3.6×10⁻⁷°,约 3 厘米,在半个格子以内。
两个数字变成了一个数字。
想换一个坐标看它怎么一刀刀切下去,可以打开交互图解的第一部分,在地图上点任意位置,逐刀播放。
2.2 为什么这个数字能当索引用
关键性质只有一条:
前 k 位相同的所有点,在数值上是一段连续区间。
取前 25 位当”格子编号”:
前缀        30317502
区间        4069146237075456 … 4069146371293183
点自己的数   4069146369298587          ← 落在区间里
于是”查一个格子”就是:
ZCOUNT nearby:geo 4069146237075456 4069146371293183
# 2
ZCOUNT 只需要两次 rank 定位再相减,是 O(log N)。如果要把成员取出来,用 ZRANGE … BYSCORE,复杂度是 O(log N + M),M 是结果数。
这就是”为什么存 ZSET”的全部理由:ZSET 按 score 有序,而 geohash 恰好把”空间相邻”编码成了”数值相邻”。换成 SET 就没法按区间扫,换成 HASH 就没法排序。
2.3 方格子找圆
格子是矩形,查询是圆,圆一定会跨格。所以要取目标格 + 周围 8 格,也就是 3×3。
但格子只是粗筛。最终必须对每个候选算一次真实球面距离:
格子粗筛  →  候选 41 个
距离精筛  →  真的在 500 米内:2 个
GEOSEARCH 在内部一定会做这一步精筛,不管你带不带 WITHDIST。WITHDIST 只是把已经算好的距离一起返回给你。
三、Redis 里的数据模型(实测)
模拟程序运行时,Redis 里一共四个 key:
| key | 类型 | 实测值 | 内容 |
|---|---|---|---|
nearby:geo | zset (skiplist) | ZCARD 1001,69,875 B | u:0545 → 4069146369298587 |
nearby:online | zset | ZCARD 1001 | u:0545 → 1795078333704(最后活跃毫秒) |
nearby:users | hash | HLEN 1001 | u:0545 → {"name":"许丽娟1","gender":"male","online":false,"lastSeen":...} |
nearby:config | hash | total=1000 | 模拟的用户总数,程序重启时用来判断要不要重新生成数据 |
一条真实记录:
member : u:0545
score  : 4069146369298587
hex    : 0xe74ddf7e1909b
GEOPOS : 116.31849735975266, 39.86335055842804
profile: {"name":"许丽娟1","gender":"male","online":false,...}
注意 nearby:geo 里有什么、没有什么:
✓ member = "u:0545"   score = 4069146369298587
✗ 名字、性别、年龄、在线状态 …… 全都没有
Redis GEO 只回答”这个 id 在哪个格子、离我多远”,不回答”这个人是谁”。所以一次查询必然是两跳:
第一跳  问 geo  →  一批 id + 距离
第二跳  问 users →  id 换资料
内存成本:69,875 B / 1001 人 ≈ 70 字节/人。 这个数有两个前提,后面估算时要记住:
- member 是
u:0545这种 6 字节的短 id。换成真实业务里 19 位的雪花 id,每人还要多出十几到二十字节。 MEMORY USAGE默认只抽样 5 个元素来估算整个 key。要精确值,得用MEMORY USAGE nearby:geo SAMPLES 0。
四、模拟程序的实现
程序用 Node 24 写,没有引入任何 npm 依赖(连 Redis 客户端都是手写的),前端用原生 Canvas 画地图。
4.1 架构
浏览器(HTML + Canvas 2D)                 Node 单进程
  ├─ /api/snapshot 启动时全量拉取
  ├─ /api/stream   SSE,每 500ms 收增量  ←──  模拟引擎(500ms tick)
  └─ /api/nearby   交互触发 + 每 2s 轮询  ←──  HTTP 路由
                                                    ↓
                                          RESP 客户端(手写,node:net)
                                                    ↓
                                          Redis 8.10.1
4.2 一次查询的完整时序
在地图上把代表自己的点(member 叫 u:me)拖到新位置,会触发两条命令:
# ① 写:新位置进 Redis
GEOADD nearby:geo 116.3971 39.9165 u:me
# ② 读:以新位置为圆心查 5km 内
GEOSEARCH nearby:geo FROMLONLAT 116.3971 39.9165 BYRADIUS 5 km ASC COUNT 2000 WITHDIST WITHCOORD
圆心就是刚写进去的坐标。也可以写成 FROMMEMBER u:me,让 Redis 自己去取位置,省得两边坐标对不上。
Redis 内部大致做了这些事:
- 根据半径选一个格子层级(step),算出圆心所在的格子
- 取这个格子和周围 8 个邻格,用不到的邻格会被跳过
- 对每个格子做 score 区间扫描,拿到候选 id
- 对每个候选算真实球面距离,丢掉超出半径的
- 按距离排序,取前 2000
实测返回 约 370 条,耗时 1.8 ms。
回到服务端(这部分才是业务代码):
③ 剔除 u:me                          → 约 369 条
④ HMGET nearby:users <这批 id>        → 一批 JSON
⑤ 按在线状态、性别过滤
⑥ 按 (page-1)*pageSize 切片,取第 1 页
4.3 写路径
每 500 ms 一个 tick:
1. 所有人朝目标点走约 0.8 米
2. 只挑「位移 > 30m」或「距上次上报 > 5s」的人   ← 节流
3. 一条 pipeline:GEOADD + ZADD nearby:online
4. SSE 只推变化的那几个人
为什么要节流:模拟程序最多可以开到 5 万人。如果每个人每个 tick 都上报,就是每秒 10 万次上报。每次上报是 GEOADD + ZADD 两条命令,合计每秒 20 万条,单线程的 Redis 会被直接打满。
为什么不先删再插:对同一个 member 再执行一次 GEOADD 就是覆盖,天然幂等。
4.4 关键取舍
| 决定 | 原因 |
|---|---|
离线用户不从 nearby:geo 删除 | 为了直观展示”先粗取、再过滤”:离线的人留在候选里,由服务端过滤掉。生产环境应该及时清理,见 6.7 |
COUNT 2000 而不是分页 | Redis GEO 没有 OFFSET,只能一次取够候选,再在服务端分页;候选数达到上限时要告诉调用方结果可能被截断 |
| 过滤放在服务端 | 不能把数据全量下发给前端 |
如果只需要”随便给我 N 个附近的人”,不关心是不是最近的 N 个,可以加 ANY:GEOSEARCH … COUNT 50 ANY。Redis 找够 50 个就停,不再对全部候选排序。高峰期可以用它来降级。
五、三个容易搞错的点(实测)
5.1 score 的差值不是距离
这是最容易想当然的地方。
取同一条经线上、纬度相差约 0.28 米的两个点:
| 纬度 | score | |
|---|---|---|
| A | −82.3932835 | 2850893384381908 |
| B | −82.3932810 | 2851626392133760 |
| 差 0.282 m | 差 733,007,751,852 |
再看模拟数据里相距最远的两个人:
| 距离 | score 差 | |
|---|---|---|
| u:0899 ↔︎ u:0808 | 18,799 m | 727,852,219,987 |
0.28 米差出 7330 亿,18.8 公里差出 7280 亿。 量级几乎一样。
把模拟数据里 600 个人两两配对,得到约 18 万组 (真实距离, score 差值),随手就能找到反例:
| 组合 | 真实距离 | score 差值 |
|---|---|---|
| 一对 | 300 m | 557,291 |
| 另一对 | 603 m(更远) | 419,569(更小) |
更远的那一对,差值反而更小。 按差值排序,顺序会排反。
同样是 100 米,方向不同,差值也不同:
向北 100 m → 差值 736,428
向东 100 m → 差值 386,952     (差 1.9 倍)
原因:score 是位交错,不是线性组合。给纬度那个 26 位整数加 1,如果它的低位正好是 0111…1,加 1 就会进位:低 20 位全部清零,第 20 位变成 1。在交错后的 score 里,纬度第 i 位的权重是 4ⁱ,所以 score 的变化量是:
+ 4²⁰ − (4⁰ + 4¹ + … + 4¹⁹) = 4²⁰ − (4²⁰ − 1)/3 ≈ ⅔ × 4²⁰ ≈ 7330 亿
和上面实测的 733,007,751,852 吻合。地面上只挪了一个最小格,数值上却跳了七千亿。
可以依赖什么:
| 用法 | 靠不靠得住 |
|---|---|
| 前缀相同 ⇒ 同一格子 | ✓ 严格成立 |
| 前缀长度 ⇒ 格子边长可算 | ✓ 严格成立 |
| 前缀不同 ⇒ 离得远 | ✗ 可能只是跨了格子边界 |
| 两个数的差值 ⇒ 距离 | ✗ 不成立 |
score 能回答”你是谁家的孩子”(前缀),不能回答”你离我多远”(差值)。
交互图解的第三部分把北京上空 16 × 16 个格子按 score 顺序连成一条 Z 形线,能直观看到”score 只差 1,地面却隔着 35 km”的跳跃。
所以整个方案里从来没有对 score 做过一次减法。WITHDIST 返回的米数是真算出来的。
5.2 格子大小怎么选
规则:格子短边 ≥ 半径。
原因是 3×3 能保证覆盖的圆半径,正好等于一个格子的边长。最坏情况是圆心落在格子的角上,这时往左只剩 1 格、往下只剩 1 格,半径为 s 的圆仍然一定落在 3×3 里。
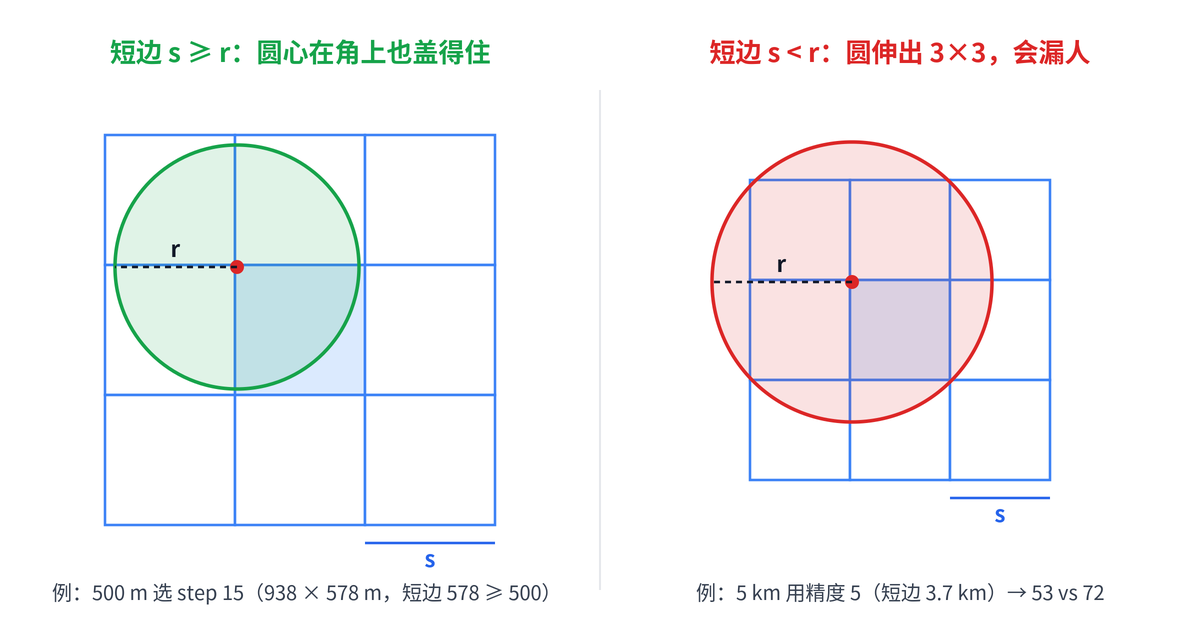
500 米半径的实测(圆心 116.3971, 39.9165):
GEOSEARCH 500 m → 2 个人
| Redis step | 格子(经×纬) | 3×3 保证覆盖 | 够不够 | 9 格圈到 |
|---|---|---|---|---|
| 12 | 7504 × 4623 m | 4623 m | ✓ | 975 |
| 13 | 3752 × 2311 m | 2311 m | ✓ | 649 |
| 14 | 1876 × 1156 m | 1156 m | ✓ | 188 |
| 15 | 938 × 578 m | 578 m | ✓ 刚好 | 41 |
| 16 | 469 × 289 m | 289 m | ✗ | 7 |
| 17 | 235 × 144 m | 144 m | ✗ | 2 |
500 m → step 15。这是还能保证不漏的最细一层。
在交互图解里拖动查询圆、改半径,可以看到 Redis 选的 step、实际扫了哪几格、跳过了哪几格,以及候选比结果多出多少。勾上「固定精度 5 的九宫格」,还能看到 5.3 节说的漏人现象。
有两个坑。
① 格子不是正方形。 同一个 step,经度方向 938 米,纬度方向只有 578 米。主要原因是纬度只切 ±85.05°(跨度约 170°),而经度切 360°,所以按度数算,纬向格子只有经向的 0.47 倍。另一方面,纬度 40° 处 1 度经度只有 1 度纬度的 cos 40° ≈ 0.77 倍长,这会把差距缩小一些。两者合起来,578 / 938 ≈ 0.47 / 0.77 ≈ 0.62。所以判据要取短边:
min(经向边长, 纬向边长) × m ≥ r // 3×3 时 m=1,5×5 时 m=2,(2m+1)×(2m+1) 一般情况
② 粗格子省事,但扫得多。 如果格子是正方形、边长恰好是 r/m,扫描面积与圆面积之比是:
((2m+1)·r/m)² / (π r²) = (2 + 1/m)² / π
| 网格 | step | 保证覆盖 | 扫描面积/圆面积(实测格子) | 正方形格子理论值 | 邻域内人数 |
|---|---|---|---|---|---|
| 3×3 | 15 | 578 m ✓ | 6.2× | 2.86× | 41 |
| 5×5 | 16 | 578 m ✓ | 4.3× | 1.99× | 28 |
| 9×9 | 17 | 576 m ✓ | 3.5× | 1.61× | ~10 |
实测值比理论值大了约一倍,原因有两个:格子是 1.62 : 1 的长方形,长边方向白扫了;短边 578 m 比 500 m 还多出 16%。以 3×3 为例,2.86 × 1.62 × (578/500)² ≈ 6.2,和实测完全对上。
m → ∞ 时,正方形格子的比值趋近 4/π ≈ 1.27,也就是圆的外接正方形。永远到不了 1,因为你在用方格子找圆。实践中一般取 9 格或 25 格,再细的话查询次数会爆炸。
5.3 为什么”9 格”有时不够
我在地图上画过一个”九宫格”示意:用精度 5 的标准 geohash(经 13 位、纬 12 位)取 3×3 个格子,数格子里的人,再和 GEOSEARCH 的结果对比:
9 格数出来  →  53 人
GEOSEARCH  →  72 人
这不是 bug,是格子选小了:
精度 5 的格子 = 3.7 km(经) × 4.9 km(纬)
短边 3.7 km < 半径 5 km   →   3×3 保证不够   →   数出来偏少
Redis 自己不会犯这个错:它会按半径自动选格子层级,而不是死守一个固定精度。自己实现格子检索时,一定要先按 5.2 的规则选精度。
六、千万级在线的分片设计
这一节是设计推算,模拟程序里没有实现,估算值都标了”估”。
6.1 先算账
geo 这把 key 实测约 70 B/人(短 id)。但一个在线用户在 Redis 里不止这一条:还有活跃时间(act)和精简资料(prof)。换成真实 uid、资料只存昵称、性别、头像 id 这类字段的话,三把 key 合计估 300~500 B/人,下表按 400 B 算:
| 在线规模 | geo 单 key(70 B/人) | 三把 key 合计(估 400 B/人) | 上报次数/秒(30s 节流) |
|---|---|---|---|
| 100 万 | 70 MB | 0.4 GB | 3.3 万 |
| 300 万 | 210 MB | 1.2 GB | 10 万 |
| 1000 万 | 700 MB | 4 GB | 33 万 |
每次上报至少是 GEOADD + ZADD 两条命令,所以命令数还要再乘 2。
先纠正一个直觉:内存不是第一个爆的。 就算 1000 万在线,总量也就几个 GB,一台机器装得下。
真正先爆的是这些:
| 瓶颈 | 为什么 |
|---|---|
| 单线程 CPU | 每秒几十万条命令打进一个实例,单核跑满,所有查询一起排队 |
| 大 key 连锁反应 | RDB 落盘、主从全量同步、集群迁移 slot,都要整体搬运这个 key;DEL 一个几百 MB 的 key 会卡住主线程(至少要换成 UNLINK 异步释放) |
| 热区倾斜 | 全国的流量集中在少数几个城市的商圈里 |
6.2 三层抽象:cell / shard / key
| 概念 | 是什么 | 由什么决定 | 变化频率 |
|---|---|---|---|
| cell | 地球切成的小块 | 坐标 + 精度 | 永不变 |
| shard | 一组 cell 的集合 | 映射表 | 可随时调整 |
| key | Redis 键 | 前缀 + shard | 随分片变 |
关键点:分片 ID 不是”从坐标算出来的”,而是”坐标 → cell → 查表 → shard”。
不要用 hash(cell) % N,哈希不认识人口密度。北京国贸、广州天河这类商圈,5 个 cell 可能各有 10 万人;青海可能 500 个 cell 各只有 50 人。哈希之后,前者照样可能挤在同一台机器上,后者散在 100 台机器上空转。
6.3 Key 的定义
nearby:geo:{s017}       # ZSET  member=uid  score=52位 geohash
nearby:act:{s017}       # ZSET  member=uid  score=最后活跃毫秒
nearby:prof:{s017}      # HASH  uid -> 精简资料
{} 是 Redis Cluster 的 hash tag:tag 相同的 key 会落在同一个 slot,于是可以 pipeline、跑 Lua 原子操作。不加 tag 的话,这三把 key 可能分散到三个节点上,多 key 命令和 Lua 会直接报 CROSSSLOT。
单机或哨兵模式没有 slot,但也建议一律加上,将来迁到集群时不用改 key。
6.4 映射表
cell 建议用 H3,不要用 geohash 字符串前缀。geohash 6 位的格子大约是 1.2 km × 0.6 km,长宽差 2 倍;H3 是近似等面积的六边形,每个 cell 的邻居距离都一样。
# H3 res 8 的 cell,例:天安门附近的 8831aa4289fffff 和它的邻居
HSET nearby:cellmap:v3  8831aa4289fffff s017  8831aa42c7fffff s017  ...
规则:一个 shard 装到约 3 万人,就开下一个。
| 能力 | 怎么做 |
|---|---|
| 合并稀疏格 | 几十个没什么人的 cell 塞进同一个 shard |
| 拆分密格 | 先按空间拆:把 res 8 换成它的 7 个 res 9 子格,分给不同 shard,查询仍然只打相关的 shard。只有单个 res 9 子格仍然超过 3 万人时,才按 hash(uid) % k 再拆(30 万人就拆成 k ≈ 10 份),代价是查这个格子要扇出到全部 k 个子分片 |
| 调整映射 | 见 6.7 的”映射表迁移”,不能只改表 |
6.5 查询时怎么扇出
六边形没有”短边”,覆盖范围要用 H3 的 grid_disk(cell, k)(以中心格为圆心向外扩 k 圈)。以天安门附近为圆心,用 h3-py 4.5.1 采样实测,要保证覆盖需要:
| 半径 | res 8(边长约 530 m) | res 7(边长约 1.4 km) |
|---|---|---|
| 500 m | k=2,19 个 cell | k=1,7 个 cell |
| 5 km | k=9,271 个 cell | k=4,61 个 cell |
所以小半径和大半径最好用不同的精度来存或来查,不要让一次 5 km 查询扇出成 271 个 cell。
查询流程:
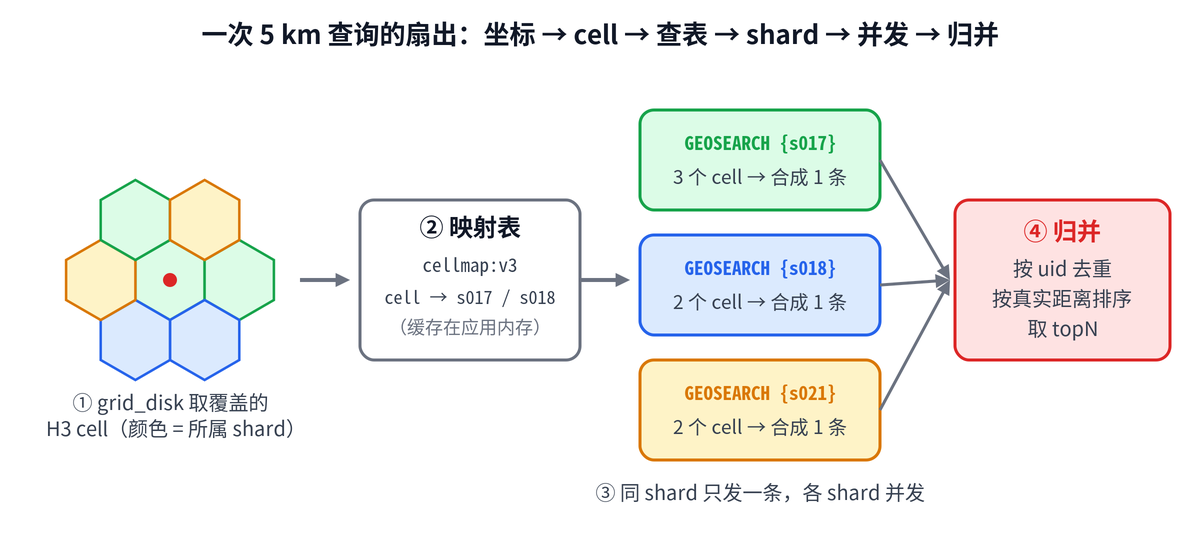
1. 坐标 + 半径 → 覆盖的 cell 集合(grid_disk)
2. cell → shard(查表,批量 HMGET;映射表很小,可以缓存在应用内存里)
3. 按 shard 分组:同一个 shard 只发一条 GEOSEARCH   ← 容易漏
4. 并发打各 shard(Promise.all,不能串行)
5. 归并 + 按 uid 去重 + 按真实距离排序 + 取 topN
第 3 步最容易漏。shard 的 key 里装的是整片区域,所以对每个 shard 直接以原圆心、原半径发一条 GEOSEARCH 就行,不用一个 cell 一个 cell 地扫。9 个 cell 落在 3 个 shard,就只有 3 次请求,而不是 9 次。
6.6 300 万在线的具体数字(估)
| 项 | 值 |
|---|---|
| cell | H3 res 8(约 0.74 km²),按需创建,只有出现过人的 cell 才进映射表 |
| cell 数 | 全国城市建成区约 6 万多 km²,对应 8~9 万个 res 8 cell(量级) |
| 每 shard 目标 | 3 万人 |
| shard 数 | 100 |
| 每 shard 内存 | 3 万 × 400 B ≈ 12 MB(三把 key 合计) |
| 每 shard 上报 | 1000 次/秒,即 2000 条命令/秒,单核占用很低 |
| 每 shard key 数 | 3 |
| 总 key 数 | 300 + 映射表 |
| 实例数(每台 25 片) | 4 主 + 4 从 |
6.7 几个必须处理的细节
用户跨 shard 移动:如果只写新 shard,旧 shard 里会留下”幽灵位置”。推荐的顺序是 先写新 → 再删旧 → 查询时按 uid 去重。允许短暂重复,不允许丢失。
要删旧,就得知道旧 shard 是哪个。不要为此给每个用户建一个 key。可以由上报服务在用户的长连接或会话里缓存 last_shard;会话丢了也没关系,旧记录会被下面的过期清理带走。
乱序上报:网络抖动时,旧位置可能比新位置晚到,把新位置覆盖掉。geo 和 act 在同一个 slot 里,可以用一段 Lua 按时间戳做保护:
-- KEYS[1]=nearby:geo:{s017}  KEYS[2]=nearby:act:{s017}
-- ARGV: lon lat uid ts
local old = redis.call('ZSCORE', KEYS[2], ARGV[3])
if old and tonumber(old) >= tonumber(ARGV[4]) then return 0 end
redis.call('GEOADD', KEYS[1], ARGV[1], ARGV[2], ARGV[3])
redis.call('ZADD',   KEYS[2], ARGV[4], ARGV[3])
return 1
映射表迁移:只改表的话,旧 shard 里的人立刻就”查不到”了,新 shard 里又还没有人。正确做法是给映射表加版本号(cellmap:v3 → cellmap:v4):
- 发布 v4,上报双写(按 v3 和 v4 各写一份),查询双读并去重
- 等过一个过期窗口(比如 5 分钟),活跃用户都已经按 v4 重新上报过
- 停止双写双读,旧数据交给过期清理处理
不要给每个用户建 key:300 万用户就是 300 万个 key,光是 key 本身的开销和碎片就够呛。一个 shard 三把 key 就够了。
不要把时间戳放进 key:nearby:geo:20261119:1430:017 这种写法每天要新建几千个 key。时间应该放在 score 里。
清理要按成员踢,不要给大 key 设 TTL。给大 key 设 TTL,过期那一刻整片区域会同时消失。正确做法是分批找出超时的人,从三把 key 里一起删:
# 取一批 5 分钟没上报的人(Redis 6.2+ 写法;ZRANGEBYSCORE 已标记为废弃)
ZRANGE nearby:act:{s017} -inf <now-300000> BYSCORE LIMIT 0 500

# 拿到 uid 列表后,在同一个 slot 里一起删(Redis 没有 GEOZREM,GEO 数据就是普通 ZSET)
ZREM nearby:geo:{s017}  <uid...>
ZREM nearby:act:{s017}  <uid...>
HDEL nearby:prof:{s017} <uid...>
6.8 什么时候不该用 Redis GEO
Redis GEO 只擅长一件事:“这个点周围有哪些 id”。
一旦要加条件(性别、年龄、排除好友、按活跃度排序),就又回到了”先粗取再回表过滤”。过滤掉的比例一高,COUNT 2000 就得变成 COUNT 20000,延迟和资源占用一起上去。
| 场景 | 方案 |
|---|---|
| 纯地理 + 简单过滤 | Redis GEO 分片(上面这套) |
| 地理 + 多条件 + 分页 + 聚合 | Elasticsearch geo_distance + 倒排索引 |
| 超大规模 + 强实时 + 复杂排序 | 自研 H3/S2 + 内存倒排 + 多副本 |
| 只读的”附近商家” | 数据库的空间索引就够了 |
七、隐私:别让”附近的人”变成定位器
这是”附近的人”最经典的安全问题,严重程度不亚于性能问题。
三角定位攻击:如果接口返回的是精确距离(WITHDIST 是米级),攻击者只要伪造三个自己的位置,各查一次目标的距离,以三个点为圆心画圆,交点就是目标的位置,精度可以到米级。即使只返回”约 1.2 km”这种保留一位小数的距离,多换几个点也能逐步逼近。
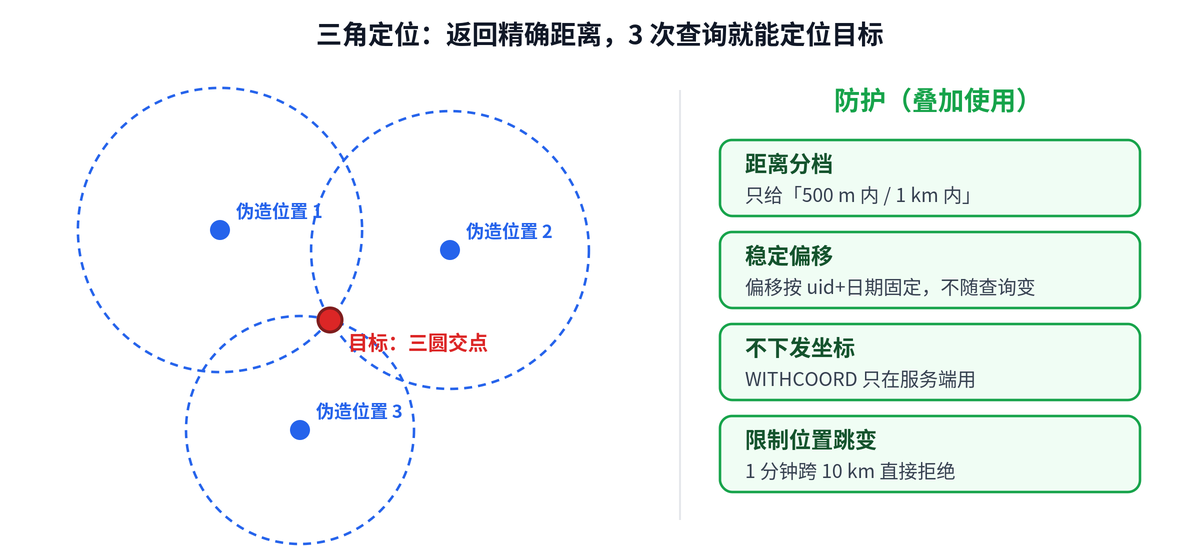
可以在交互图解里亲手试一次:在地图上点三下,就能把藏着的人定位到几十米内;切换成「距离分档」和「稳定偏移」,再看推算误差怎么变。
几条常见的防护,可以叠加使用:
| 手段 | 做法 | 注意 |
|---|---|---|
| 距离分档 | 只返回”100 m 内””500 m 内””1 km 内””5 km 内”这样的档位 | 攻击者可以沿着档位边界移动,找到”刚好跨档”的位置,所以要配合下面几条 |
| 坐标模糊 | 入库前把坐标吸附到一个格子的中心,或者加一个偏移 | 偏移必须对每个用户稳定(比如按 uid + 日期生成)。每次查询都换一个随机噪声的话,多查几次取平均就能消掉 |
| 不下发坐标 | WITHCOORD 只在服务端内部用,接口只给档位和资料 | 上面的模拟程序为了在地图上画点,把坐标发给了前端;生产环境不要这样做 |
| 限制查询位置 | 同一个账号的查询坐标短时间内大幅跳动(比如 1 分钟内跨了 10 km),就拒绝或降级 | 防伪造定位 |
| 用户可控 | 默认不可见,主动开启;可以随时清除自己的位置 | 清除时要真的 ZREM,不能只标记 |
八、附录
A. 命令速查
# 上报位置(同一 member 重复写即覆盖)
GEOADD nearby:geo 116.397128 39.916527 u:1001

# 查询(Redis 6.2+ 用 GEOSEARCH,GEORADIUS 已废弃)
GEOSEARCH nearby:geo FROMLONLAT 116.3971 39.9165 BYRADIUS 5 km ASC COUNT 2000 WITHDIST WITHCOORD

# 以某个成员的位置为圆心
GEOSEARCH nearby:geo FROMMEMBER u:1001 BYRADIUS 5 km ASC COUNT 50

# 只要 N 个、不要求最近(找够就停,高峰降级用)
GEOSEARCH nearby:geo FROMLONLAT 116.3971 39.9165 BYRADIUS 5 km COUNT 50 ANY

# 两个人的距离
GEODIST nearby:geo u:1001 u:1002 km

# score / 坐标 / geohash 字符串
ZSCORE  nearby:geo u:1001
GEOPOS  nearby:geo u:1001
GEOHASH nearby:geo u:1001

# 按 score 区间取成员(自己做格子扫描时用;6.2+ 写法)
ZRANGE nearby:geo 4069146237075456 4069146371293183 BYSCORE

# 删除位置(没有 GEOREM / GEOZREM,用 ZREM)
ZREM nearby:geo u:1001

# 精确内存
MEMORY USAGE nearby:geo SAMPLES 0
B. 实测数据汇总
| 项 | 值 |
|---|---|
| geo 单成员内存 | ~70 B(69,875 B / 1001 人,6 字节短 id) |
| 5 km 查询候选 | ~370 条 |
| 5 km 查询耗时 | ~1.8 ms |
| 500 m 查询结果 | 2 人 |
| 500 m 的 3×3(step 15) | 41 个候选,扫描面积是圆的 6.2 倍 |
| 精度 5 的 9 格 vs GEOSEARCH | 53 vs 72(格子选小了) |
| 0.282 m 的 score 差 | 733,007,751,852(≈ ⅔ × 4²⁰) |
| 18,799 m 的 score 差 | 727,852,219,987 |
| 100 m 北 / 东的 score 差 | 736,428 / 386,952 |
| 配对检验样本 | 600 人两两配对,约 18 万组 |
| H3 覆盖 5 km(res 8 / res 7) | 271 / 61 个 cell |
C. 常见误区
写这个模拟程序时实际踩过、或者差点踩到的判断:
| # | 想当然的判断 | 实际情况 |
|---|---|---|
| 1 | score 差值可以用来比远近 | 不行,见 5.1。0.28 米能差出 7330 亿 |
| 2 | 精度 5 的 3×3 应该能覆盖 5 km | 短边 3.7 km < 5 km,不够。这就是 53 vs 72 的原因 |
| 3 | ZCOUNT 是 O(log N + M) | 是 O(log N)。O(log N + M) 的是 ZRANGE … BYSCORE |
| 4 | 不带 WITHDIST,Redis 就不算距离 | 一定会算,精筛离不开它。WITHDIST 只决定返不返回 |
| 5 | 删 GEO 成员用 GEOZREM | 没有这个命令,用 ZREM |
| 6 | 大 key 设个 TTL 就能自动清理 | 过期时整片区域一起消失,而且是删大 key。应该按成员分批踢 |
| 7 | 映射表一改,数据就”热迁移”了 | 旧数据会立刻查不到,必须双写双读过渡 |
| 8 | 自己写 Redis 客户端时,可以把嵌套数组摊平 | 必须保持原有结构,否则 GEOPOS 返回的 [[lon,lat]] 和 pipeline 的响应对帧全错 |
| 9 | GEOHASH 返回一个字符串 | 返回的是数组,每个 member 一项 |